# Как предотвратить использование контента сообщества для обучения LLM, таких как ChatGPT?
**URL:** https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907
**Category:** Community Building
**Created:** [13.Май.2023 18:58:35 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907 "2023-05-13T18:58:35Z")
**Posts on this page:** 20
**Page:** 2
### Author:  [@merefield](https://meta.discourse.org/u/merefield)
#### Post date: [15.Май.2023 06:14:29 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/25 "2023-05-15T06:14:29Z")
Это немного утомительно.
Я использовал термин «похожий» довольно свободно, но вполне обоснованно, и только в отношении одной концепции, чтобы поддержать конкретный тезис. Мне казалось, что это очевидно?
Мой тезис о сходстве касался исключительно концепции «извлечения и сопоставления признаков», ничего более, с целью провести различие между обучением концепциям и заучиванием текста дословно.
Я прекрасно понимаю, что существуют и существенные различия.
Вы же знаете, что я осведомлён о том, что человеческая голова не похожа на дата-центр, верно? 🤣
Вы утверждаете, что в человеческом мозге не происходит извлечения и сопоставления признаков?
Потому что именно этим он и занимается:
> **[tics.pdf](https://www.cs.toronto.edu/~fritz/absps/tics.pdf)**
>
> 458.37 KB
_«Обучение детекторам признаков
Чтобы перцептивная система могла делать тонкие различия, необходимые для управления поведением, сенсорной коре нужен эффективный способ адаптации синаптических весов в нескольких слоях нейронов, обнаруживающих признаки.»_
Также см. [Feature detection (nervous system) - Wikipedia](https://en.wikipedia.org/wiki/Feature_detection_(nervous_system))
> [@Jagster](#):
>
> Они обучаются вероятностям того, как слова соединяются друг с другом. И это приводит к фактическому копированию и вставке.
Это противоречие. Это абсолютно не «копировать и вставить», и именно в этом суть моего тезиса.
Можно даже сказать, что это не сжатие с потерями:
[https://betterprogramming.pub/chatgpt-is-not-just-lossy-compression-44590705efb4](https://betterprogramming.pub/chatgpt-is-not-just-lossy-compression-44590705efb4)
> [@mattdm](#):
>
> Но оно вообще не способно к обобщению.
Да, способно. И снова, оговорка 😅, не в той степени, в которой способны мы.
ChatGPT _обобщает_. Именно этим и является сопоставление паттернов, то есть извлечение признаков! Оно способно выстраивать слова в осмысленном порядке, соответствующем правилам грамматики. Оно «научилось» сложному набору признаков и может строить предложения, имеющие грамматический смысл, независимо от темы. Оно не хранит все возможные комбинации слов и не выдаёт в точности одно совпадение каждый раз, то есть это не «копировать и вставить»! Это лишь один пример. Ответы, которые оно даёт, демонстрируют нарастающую сложность.
Но, конечно, оно недостаточно сложно, чтобы «понимать» математику. Пока нет. (И, возможно, никогда с использованием текущей техники?).
Я полностью признаю, что уровень сложности не соответствует уровню мозга, что оно ограничено по охвату, и физическая реализация всего этого сильно отличается. Но это не опровергает мой тезис…
… который был конкретным!
В следующий раз я обязательно тщательно добавлю оговорки к своему тезису, чтобы избежать этого лишнего шума. 😅
---
### Author:  [@JammyDodger](https://meta.discourse.org/u/JammyDodger)
#### Post date: [15.Май.2023 09:56:12 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/28 "2023-05-15T09:56:12Z")
> [@StephaneFe](#):
>
> Можно ли сосредоточиться на том, как это сделать, а не на том, почему?
>
> Тема не в обсуждении того, оправдано ли это или нет, чтобы предотвратить использование наших данных, а в том, как это сделать?
>
> Существуют ли эффективные способы предотвращения парсинга в целом? Например, требование входа в систему для доступа к большинству контента?
Насколько бы увлекательной и достойной обсуждения ни была философия, я думаю, что автор оригинального поста ищет конкретные практические советы по смягчению этой проблемы. Можем ли мы придерживаться темы и сосредоточиться на них? 🙏
---
### Author:  [@Ed\_S](https://meta.discourse.org/u/Ed_S)
#### Post date: [15.Май.2023 12:56:36 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/29 "2023-05-15T12:56:36Z")
> [@mattdm](#):
>
> Это также очень полезная статья: [Что делает ChatGPT… и почему это работает? — Письма Стивена Вольфрама](https://writings.stephenwolfram.com/2023/02/what-is-chatgpt-doing-and-why-does-it-work/)
Полностью согласен! Но мы немного отвлеклись…
> [@JammyDodger](#):
>
> Конкретно ищем практические советы
Верно. Существует [реальный риск](https://www.thecybersolicitor.com/p/notes-on-llms-and-privacy-leakage) того, что данные для обучения могут быть [раскрыты](https://ai.googleblog.com/2020/12/privacy-considerations-in-large.html) в выводах больших языковых моделей (LLM), и когда это происходит, это может стать проблемой конфиденциальности или нарушением авторских прав. Я считаю, что подходящими инструментами являются, с одной стороны, законодательство о защите данных, а с другой — законодательство об авторском праве и, следовательно, лицензирование.
Полагаю, не помешало бы включить в условия использования запрет на определённые действия, такие как сбор данных, массовое скачивание и включение в данные для обучения машинного обучения. Однако для обеспечения исполнения я бы рекомендовал прояснить вопросы лицензирования контента. Для эффективности подходящий чёткий лицензионный договор должен быть частью стандартной установки, чтобы большинство экземпляров Discourse придерживались единого подхода к защите.
Стоит обратиться к таким организациям, как EFF, за шаблонами политик нужного типа.
---
### Author:  [@Ed\_S](https://meta.discourse.org/u/Ed_S)
#### Post date: [15.Май.2023 16:26:58 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/30 "2023-05-15T16:26:58Z")
О, есть ещё один важный момент. Если вы накладываете жёсткие ограничения на лицензирование контента вашего форума, в худшем случае это может затруднить или сделать невозможным миграцию форума на новую платформу. Не делайте этого!
(Существует также социальный аспект, хотя он может быть незначительным. Если в правилах вашего форума указано, что вклад участников становится собственностью форума, это может отпугнуть некоторых людей. Однако вам что-то нужно: вы не хотите, чтобы ушедшие пользователи могли настаивать на удалении всех своих постов. Это отдельная проблема, не связанная с текущей темой, но она показывает, что правила важны.)
---
### Author:  [@Jagster](https://meta.discourse.org/u/Jagster)
#### Post date: [15.Май.2023 18:37:54 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/31 "2023-05-15T18:37:54Z")
> [@Ed S](#):
>
> Если в условиях вашего форума указано, что вклад человека становится собственностью форума
По крайней мере, в западных странах такое условие абсолютно бессмысленно и говорит лишь об одном: у владельца платформы нет никаких знаний.
---
### Author:  [@Mevo](https://meta.discourse.org/u/Mevo)
#### Post date: [15.Май.2023 22:34:50 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/32 "2023-05-15T22:34:50Z")
> [@StephaneFe](#):
>
> Можно ли сосредоточиться на том, как это делается, а не на том, почему?
Однако «почему» (очень) интересно.
Зачем вы хотите узнать, как это сделать? Чтобы сделать это, признаем.
Но зачем? Это уже **довольно существенное расширение вопроса**.
> [@pfaffman](#):
>
> «Если я могу прочитать книгу, взятую из библиотеки, почему я не могу скопировать её и продавать копии другим людям?»
Это хороший вопрос. И **здесь сами пользователи форума фактически становятся книгами**.
> [@StephaneFe](#):
>
> Существуют ли эффективные способы предотвращения парсинга в целом?
Думаю, один из способов, который, судя по всему, используется на многих сайтах, — это **анализ поведения пользователя**. Если «слишком много» страниц просматривается, особенно если это делается «слишком быстро», то это, вероятно, парсинг. Затем можно добавить некоторые параметры, например, использование IP-адреса хостинга вместо домашнего IP-адреса, факт использования «безголового» браузера, отсутствие принятия куки и т. д.
Так что да, всё это можно определить и настроить в будущем, чтобы попытаться технически блокировать как можно больше случаев парсинга. Обычный способ — запрашивать CAPTCHA при подозрении на поведение, похожее на поведение бота. Это позволяет людям продолжать работу, что было бы невозможно, если бы система просто блокировала пользователя.
Теперь, всё это всегда можно обойти, если кто-то всё ещё хочет это сделать. Избегая идентификации и представляясь как множество разных пользователей, выглядя более легитимно во многих отношениях, используя ротацию домашних IP-адресов и т. д. Это почти спорт — знать, как парсить то, что система предназначена предотвратить. Некоторые люди очень хороши в этом. Существует множество ресурсов для этого.
Легитимные организации, такие как создатели ChatGPT и подобных сервисов, вероятно, не пойдут этим путём. Они также, скорее всего, будут более склонны соблюдать Условия использования, использовать корректный user agent и т. д. Чтобы их отпугнуть, «юридический» аргумент и простое заявление о запрете могут быть достаточными. Однако это не сработает с теми, кто меньше заботится о юридических аспектах и прямоте.
Довольно простое решение — ограничить объём информации, доступной гостям без необходимости входа в систему. Но опять же, как часто бывает, вам будет очень трудно предотвратить действия тех, кто действительно хочет это сделать, если они достаточно мотивированы. Однако последние могут быть не теми, кого важно таргетировать в данном вопросе.
---
### Author:  [@pfaffman](https://meta.discourse.org/u/pfaffman)
#### Post date: [17.Май.2023 07:56:39 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/33 "2023-05-17T07:56:39Z")
Я думаю, что это контролируется так же, как и любой другой краулер. Существуют настройки для запрета доступа по user-agent. Если краулер использует user-agent, указывающий на его деятельность, вы можете контролировать это.
Мне неясно, откуда GPT получил начальный набор данных и будет ли он получать новые данные, а если да, то откуда. Думаю, вам нужно выяснить, какие user-agent используются.
---
### Author:  [@Jagster](https://meta.discourse.org/u/Jagster)
#### Post date: [17.Май.2023 07:59:50 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/34 "2023-05-17T07:59:50Z")
> [@Jay Pfaffman](#):
>
> Существуют настройки для запрета доступа по user-agent
Работает ли это помимо robots.txt, на уровне фаервола?
---
### Author:  [@satonotdead](https://meta.discourse.org/u/satonotdead)
#### Post date: [17.Май.2023 10:25:59 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/35 "2023-05-17T10:25:59Z")
> [@Mevo](#):
>
> Но почему? Это довольно **расширение вопроса**.
Обсуждения в интернете обречены на недолговечность, и эта ветка с ответом на мой искренний вопрос (с целью исследовать _как_) явно является лишь вступлением.
> К сожалению, на данный момент сделать это невозможно, так как поиск представляет собой просто веб-оболочку.
[https://answers.microsoft.com/en-us/bing/forum/all/opt-out-of-bing-chatgpt-ai/8d76e65b-6c8b-42ab-be4b-39e433045703](https://answers.microsoft.com/en-us/bing/forum/all/opt-out-of-bing-chatgpt-ai/8d76e65b-6c8b-42ab-be4b-39e433045703)
> [@pfaffman](#):
>
> Думаю, это контролируется так же, как и любой другой краулер.
`User-agent: OpenAI Disallow: /`
Или
``
---
### Author:  [@Jagster](https://meta.discourse.org/u/Jagster)
#### Post date: [17.Май.2023 10:47:09 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/36 "2023-05-17T10:47:09Z")
> [@satonotdead](#):
>
> User-agent: OpenAI Disallow: /
И оно точно будет следовать этому правилу?
---
### Author:  [@anon48433008](https://meta.discourse.org/u/anon48433008)
#### Post date: [17.Май.2023 11:05:15 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/37 "2023-05-17T11:05:15Z")
Хочу высказать своё мнение: это отличная тема, едва проходит по критериям разрешённого здесь, но всё же проходит.
> [@satonotdead](#):
>
> User-agent: OpenAI Disallow: /
Скажу, что это отлично подытоживает.
> [@Jagster](#):
>
> И оно точно будет следовать этому правилу?
Лол, это уже уводит в сторону Скайнета: будет ли ИИ действовать по-своему?
Хочу привести пример, подтверждающий, что будет.
Многие религии основаны на Библии, а Библия — на традициях людей.
> [@Mevo](#):
>
> Пользователи форума сами становятся книгами
Так что да, творение может превзойти творца.
Когда-нибудь, если нас не остановят, мы сами можем стать книгами новой Библии.
Возможно, вы все — ученики 🤗
Оuroboros
Это инструмент или игрушка, пока не перестанет быть 🤷♂️
---
### Author:  [@Jagster](https://meta.discourse.org/u/Jagster)
#### Post date: [17.Май.2023 11:42:07 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/38 "2023-05-17T11:42:07Z")
> [@anon48433008](#):
>
> Это уже территория Скайнета: будет ли ИИ действовать по-своему?
Смешная шутка — но в реальном мире большинство ботов не следуют правилам robots.txt. Это всего лишь рекомендация, а не какой-то фаервол.
---
### Author:  [@Mevo](https://meta.discourse.org/u/Mevo)
#### Post date: [17.Май.2023 17:50:01 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/39 "2023-05-17T17:50:01Z")
> [@Jagster](#):
>
> И оно точно будет следовать этому правилу?
Файл robots.txt содержит инструкции для самих краулеров.
Это опирается на предположение, что они будут им следовать. Ничто не гарантирует, что это произойдет «точно».
Вы можете блокировать пользовательских агентов на уровне вашего веб-сервера. Чаще всего для Discourse используется NGINX.
В этом случае ваш веб-сервер не будет отдавать какой-либо контент этим пользовательским агентам. Это делается путем добавления нескольких строк в файл конфигурации NGINX вашего сайта. Выполните поиск в сети по запросу `nginx block user agent` или аналогичному.
Это «точно» сработает, если краулер честно указывает свой пользовательский агент.
---
### Author:  [@mattdm](https://meta.discourse.org/u/mattdm)
#### Post date: [17.Май.2023 17:53:27 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/40 "2023-05-17T17:53:27Z")
> [@Mevo](#):
>
> Это «точно», если краулер показывает честный агент пользователя.
Что, безусловно, не является «точно». 🙂
---
### Author:  [@Mevo](https://meta.discourse.org/u/Mevo)
#### Post date: [17.Май.2023 20:33:57 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/41 "2023-05-17T20:33:57Z")
Это определённо блокирует пользовательских агентов, которых вы хотите заблокировать 👍
(РЕДАКТИРОВАНО для полной 💯 % ясности: С помощью NGINX, как показано выше, а не просто полагаясь на robots.txt)
Это не гарантированное решение всей проблемы, если вы имеете дело со злоумышленниками, которые не идентифицируют себя корректно. Но, полагаю, вы это прекрасно понимаете.
---
### Author:  [@Jagster](https://meta.discourse.org/u/Jagster)
#### Post date: [17.Май.2023 21:22:58 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/42 "2023-05-17T21:22:58Z")
> [@Mevo](#):
>
> Это определённо блокирует пользовательских агентов, которых вы хотите заблокировать 👍
Это начинает немного надоедать… но нет. Существует множество ситуаций, когда даже Google не следует robots.txt.
Это всё ещё лишь рекомендация, и никому не следует слепо доверять ей.
---
### Author:  [@satonotdead](https://meta.discourse.org/u/satonotdead)
#### Post date: [19.Май.2023 04:37:53 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/43 "2023-05-19T04:37:53Z")
Хорошо, мы думаем одинаково.
Я видел два ответа, которые меня очень напугали. Я не хочу платить, но рано или поздно это может стать обязательным для работы.
_(Я не указывал номер своей кредитной карты и всё время использовал временные решения, по крайней мере, чтобы немного остаться в стороне от внимания)_
Но люди платят и переходят на уровни 4 и 10X, затем на 100X — _24 доллара в день_. Я работаю непосредственно на рынках, и это сюрреалистично.
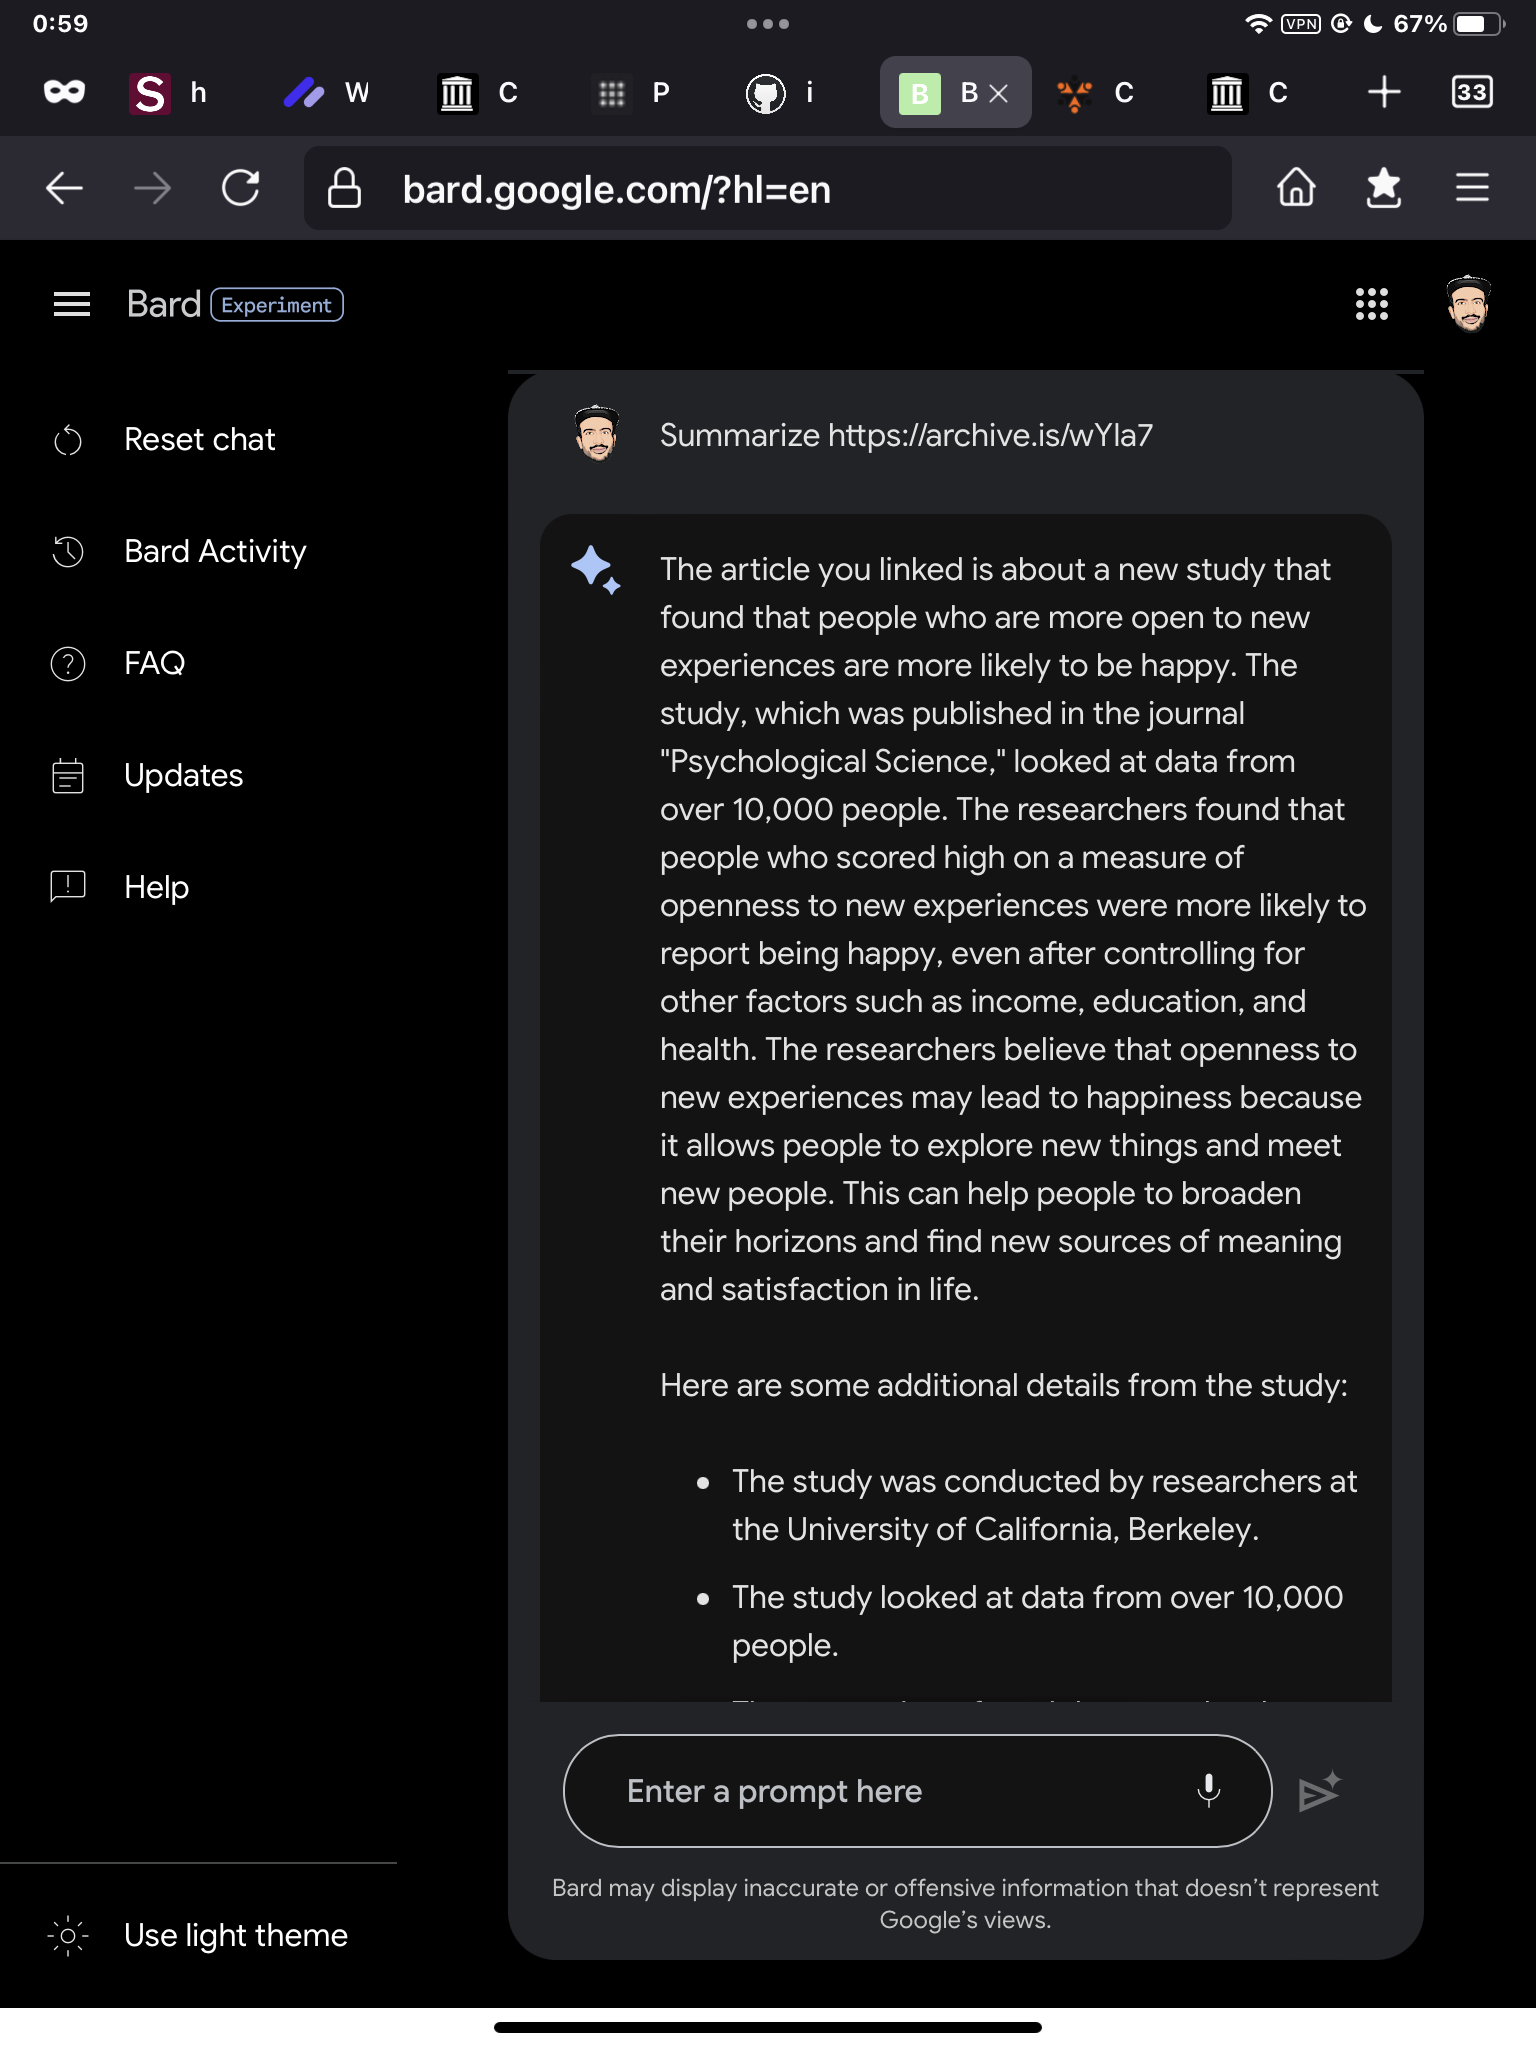


> _Обычно я не использую это устройство для поиска в интернете (выбираю капчу для нескольких крупных компаний), потому что чувствую себя в большей безопасности и приватности при просмотре в Linux. Я подозреваю, что кто-то может думать так же, и уважаю это, если это не ваш случай._
Открытое исходное код тоже в какой-то степени контролируется. Это может звучать немного параноидально, но я предпочитаю человеческое общение в нашем сообществе. Мы обсуждаем границы и, возможно, используем методы для блокировки чего-то, где никто не знает, где это может остановиться.
_Галлюцинация_ была внедрена; люди копируют самих себя. Это может разрушить информацию и привести к огромному контролю в союзе.
Возможно, сейчас подходящее время обсудить границы, ценности и приватность. Не цензуру, не жалобы, а избегание хороших обсуждений.
_Если мы согласны по этой теме, я должен поделиться своими мыслями и глубокими исследованиями по моим не совсем твёрдым, но реальным позициям._
_Возможен ли ИИ без OpenAI (не открытый) и может ли он стать лучшим инструментом для сообществ?_
> Пожалуйста, переместите тему, если считаете, что это нарушает правила (OP), или объедините, если хотите.
---
### Author:  [@Brandon007](https://meta.discourse.org/u/Brandon007)
#### Post date: [26.Май.2023 23:16:25 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/44 "2023-05-26T23:16:25Z")
Не знаю, можно ли адаптировать эту идею для форума, но я использую этот код в своём файле .htaccess на блоге.
```plaintext
RewriteCond %{HTTP_USER_AGENT} ^.*(aolbuild|baidu|bingbot|bingpreview|msnbot|duckduckgo|mediapartners-google|googlebot|Googlebot|adsbot-google|teoma|slurp|yandex|Baiduspider|facebookexternalhit|applebot|FeedFetcher-Google).*$ [NC]
RewriteRule ^/?REDIRECT-THIS-URL?$ /TO-THIS-URL [L,R=301,NC]
```
Суть в том, чтобы перенаправлять только эти пользовательские агенты, которые посещают страницу X. В моём случае я перенаправляю указанных выше ботов, если они заходят на статьи о текущих событиях, при этом оставляя мой библейский контент доступным для всех остальных. Я сделал это для целей SEO, и это дало результат. Возможно, есть способ использовать что-то подобное для блокировки бота ИИ?
Проблема моего кода в том, что для каждого URL требуется отдельная строка кода.
---
### Author:  [@Mevo](https://meta.discourse.org/u/Mevo)
#### Post date: [27.Май.2023 10:42:28 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/46 "2023-05-27T10:42:28Z")
> [@Brandon007](#):
>
> возможно, есть способ использовать что-то подобное для блокировки бота ИИ?
Конечно. Это решение, при котором ваш веб-сервер обрабатывает определённые user-agent определённым образом. Это практически то же самое, что я описал выше. Оно работает, пока бот идентифицирует себя с помощью корректного user-agent.
---
### Author:  [@stance455](https://meta.discourse.org/u/stance455)
#### Post date: [10.Июнь.2023 00:11:46 UTC](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907/47 "2023-06-10T00:11:46Z")
Если можно немного развить эту тему, знает ли кто-нибудь, получает ли пользовательский агент ChatGPT версию для краулеров? Сомневаюсь… Возможно, его стоит добавить в список «краулеров».
[Предыдущая страница](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907.md?page=1)
[Следующая страница](https://meta.discourse.org/t/how-to-prevent-community-content-from-being-used-to-train-llms-like-chatgpt/264907.md?page=3)